Индексиране и обхождане от търсачки
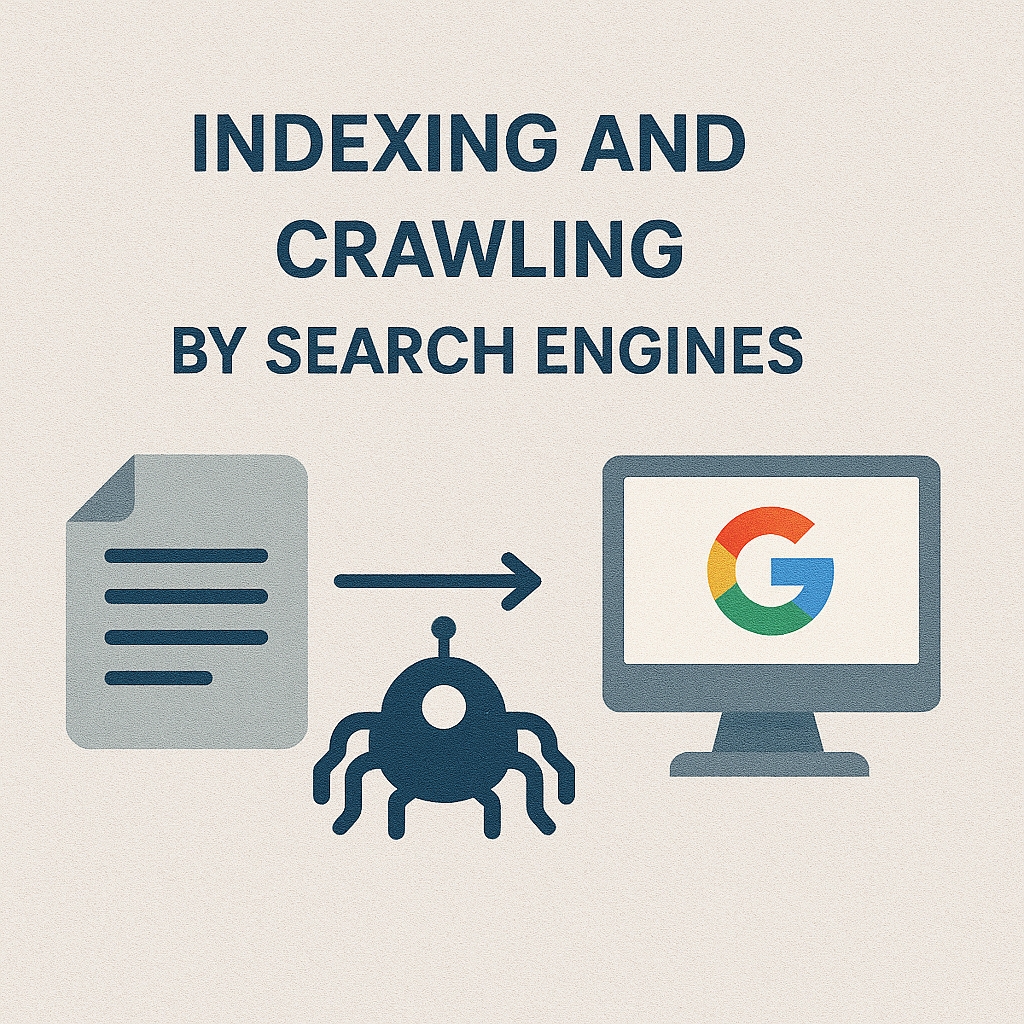
За да се появи дадена страница в резултатите от търсене в Google, тя първо трябва да бъде открита и „прочетена“ от търсачката. Този процес започва с така нареченото обхождане (crawling) – това е моментът, в който автоматичните ботове на Google (наричани Googlebot) посещават страниците на сайта и събират информация за тях. Ботът следва връзки от една страница към друга, точно както потребител би кликал по менюта и линкове.
След като страницата бъде обходена, следва вторият ключов етап – индексиране (indexing). Това означава, че Google записва съдържанието на страницата в своята база данни (индекс), където то може да бъде използвано при търсене. Индексирането включва анализ на текста, структурата, таговете, изображенията и други елементи, за да се разбере темата и качеството на съдържанието.
Тези два етапа – обхождане и индексиране – са абсолютно задължителни. Ако една страница не бъде обходена, Google няма да я „види“. Ако не бъде индексирана, тя няма да бъде „запомнена“ и няма как да се покаже в резултатите от търсене, дори и да има отлично съдържание. За търсачките такава страница буквално не съществува.
Ето защо, когато се прави SEO, първата проверка винаги трябва да е:
„Може ли Google да достъпи и индексира тази страница?“
Ако отговорът е „не“, всички останали усилия – като оптимизация на текстове, линкове или ключови думи – просто няма да дадат резултат.
Как работят Googlebot и другите ботове?
-
Обхождане (Crawling):
Търсачките използват специални програми, наречени ботове (например Googlebot), за да откриват нови или променени страници. Те следват връзки от страница на страница и сканират съдържанието. -
Индексиране (Indexing):
След като една страница бъде обходена, нейното съдържание се анализира и съхранява в индекса на търсачката – гигантска база данни, която Google използва при всяко търсене.
Инструменти и файлове, които контролират обхождането и индексирането:
robots.txt е специален текстов файл, който се поставя в кореновата директория на сайта (например: https://example.com/robots.txt) и има за цел да указва на търсачките кои части от сайта да не обхождат. Той не „скрива“ съдържание от Google, а просто моли ботовете (роботите на търсачките) да не влизат в определени страници или директории.
Този файл е много полезен, когато имаш страници, които не са предназначени за публичен достъп – например административни панели, тестови версии или вътрешни ресурси, които не искаш да се обхождат излишно.
Какво е User-agent?
User-agent в robots.txt е начин да посочиш към кой бот се отнасят инструкциите. Различните търсачки използват различни ботове. Например:
-
Google използва
Googlebot -
Bing използва
Bingbot -
Всички ботове се обобщават с
*(звездичка)
Пример:
User-agent: *
Disallow: /admin/
Това казва на всички ботове: „Не обхождайте страниците в директорията /admin/“.
Важно уточнение:
robots.txt не забранява индексирането директно. Ако друга страница линква към забранената с robots.txt страница, Google може все пак да я индексира, дори без да я е обхождал. В такъв случай ще я добави в резултатите от търсене, но с ограничена информация (например само заглавието и URL адреса).
Ако искаш страница изцяло да не се индексира, трябва да използваш noindex мета таг вътре в HTML кода ѝ – а за това тя трябва да бъде достъпна за обхождане.
С други думи:
-
robots.txt = „Не влизай тук.“
-
noindex = „Може да влезеш, но не я показвай в търсачката.“
2.1. robots.txt
-
Това е текстов файл, който се намира в кореновата директория на сайта (site.com/robots.txt).
-
Служи, за да казва на ботовете кои страници да не обхождат.
-
Пример:
User-agent: *
Disallow: /admin/
Важно: Ако забраниш страница чрез robots.txt, тя няма да бъде обходена, но може да бъде индексирана, ако други страници линкват към нея.
2.2. sitemap.xml
sitemap.xml е специален файл, който съдържа списък с всички важни страници на уебсайта ти. Служи, за да помогне на търсачките по-лесно и по-бързо да открият и обхождат съдържанието на сайта.
Файлът се намира обикновено на адрес: https://example.com/sitemap.xml и включва URL адреси на страници, както и информация кога са обновени и колко често се променят.
Сайтмапът не гарантира, че всички страници ще бъдат индексирани, но помага на Google да разбере как е структуриран сайтът ти и кои страници са важни.
-
XML файл, който съдържа списък с всички важни страници в сайта.
-
Помага на търсачките да открият и обхождат всички налични URL-и.
-
Обикновено се генерира автоматично от CMS или SEO плъгин.
➡ Пример: https://example.com/sitemap.xml
➡ Подай го в Google Search Console > Sitemap
2.3. Canonical тагове
Canonical тагът е HTML елемент, който показва на търсачките коя е основната (оригиналната) версия на страница, когато има няколко сходни или дублирани версии.
Използва се така:
<link rel=“canonical“ href=“https://example.com/produkt-a/“ />
Това казва на Google: „Тази страница е копие, а оригиналната е на посочения адрес.“
Canonical тагът помага да се избегне дублирано съдържание и насочва цялата SEO стойност към една основна страница.
-
HTML тагове, които посочват оригиналната (канонична) версия на дадена страница.
-
Използват се, когато имаш дублирано съдържание (напр. няколко URL-а със сходна информация).
-
Пример:
<link rel=“canonical“ href=“https://example.com/produkt-a/“ />
Така Google разбира коя версия да индексира и показва в резултатите.
Как да провериш кои страници са индексирани?
-
В Google Search Console – меню „Pages > Indexed“
-
В търсачката: site:example.com
Това показва всички индексирани страници от домейна.
Какво да направиш, ако страница не се индексира?
-
Провери дали не е блокирана от robots.txt
-
Увери се, че няма таг
<meta

name="robots" content="noindex"> -
Добави я в sitemap.xml
-
Изпрати я ръчно в Google Search Console чрез „Inspect URL“
Индексирането е основата на SEO видимостта. Ако Google не може да достигне, разбере или индексира съдържанието ти – то няма как да се класира, независимо колко добре е написано.